お問い合わせはこちら

もし全てのサイトがAIを拒絶したらどうなるのか
2026/11/10
もしネット全体が「AIお断り」になったら?
✍ 筆者より
先日、robots.txt の話題をきっかけに、ふと思ったことがあります。もし世界中のサイトが、AIの学習も情報の収集もすべて断ったら、いったいどうなるのでしょうか。面白そうだと思ったので、AIと一緒に思考実験をしてみました。
なお、この記事の構成と下書きはAIに任せ、意見や体験は私自身の言葉で書いています。
先に答えを言ってしまうと、AIは学ぶのをやめません。変わるのは「学び方」です。ネットからタダで集めるのをやめて、「お金を払って買う」「自分で作る」方向に変わっていきます。しかもこの変化は、もう始まっています。
robots.txt(ロボッツテキスト)は、Webサイトに貼る「張り紙」のようなものです。サイトを見に来る機械(ロボット)に向けて、「このロボットは入らないでね」と伝えるためのものです。最近は、AIの勉強用ロボットだけを名指しで断るサイトが増えています。
では、もし世界中のサイトが全部この張り紙を出したら、AIはどうなるのでしょうか。この記事では、そんな「もしも」の話から、AIが何を食べて育っているのかを考えてみます。
まず知っておきたいこと:張り紙は「お願い」にすぎない
robots.txt は、あくまで「お願い」です。カギのかかったドアではありません。守るかどうかは、来たロボットしだいです。そのため、本気で断りたいサイトは、別の仕組みを使ってロボットを門前払いすることもあります。
ただ、この「お願い」をルールにしようという動きもあります。ヨーロッパ(EU)では、2025年7月に公表されたAI会社向けのルールブックに、「robots.txt を守ること」がはっきり書かれました。
この記事では、「みんながちゃんと張り紙を守る世界」を想像して話を進めます。
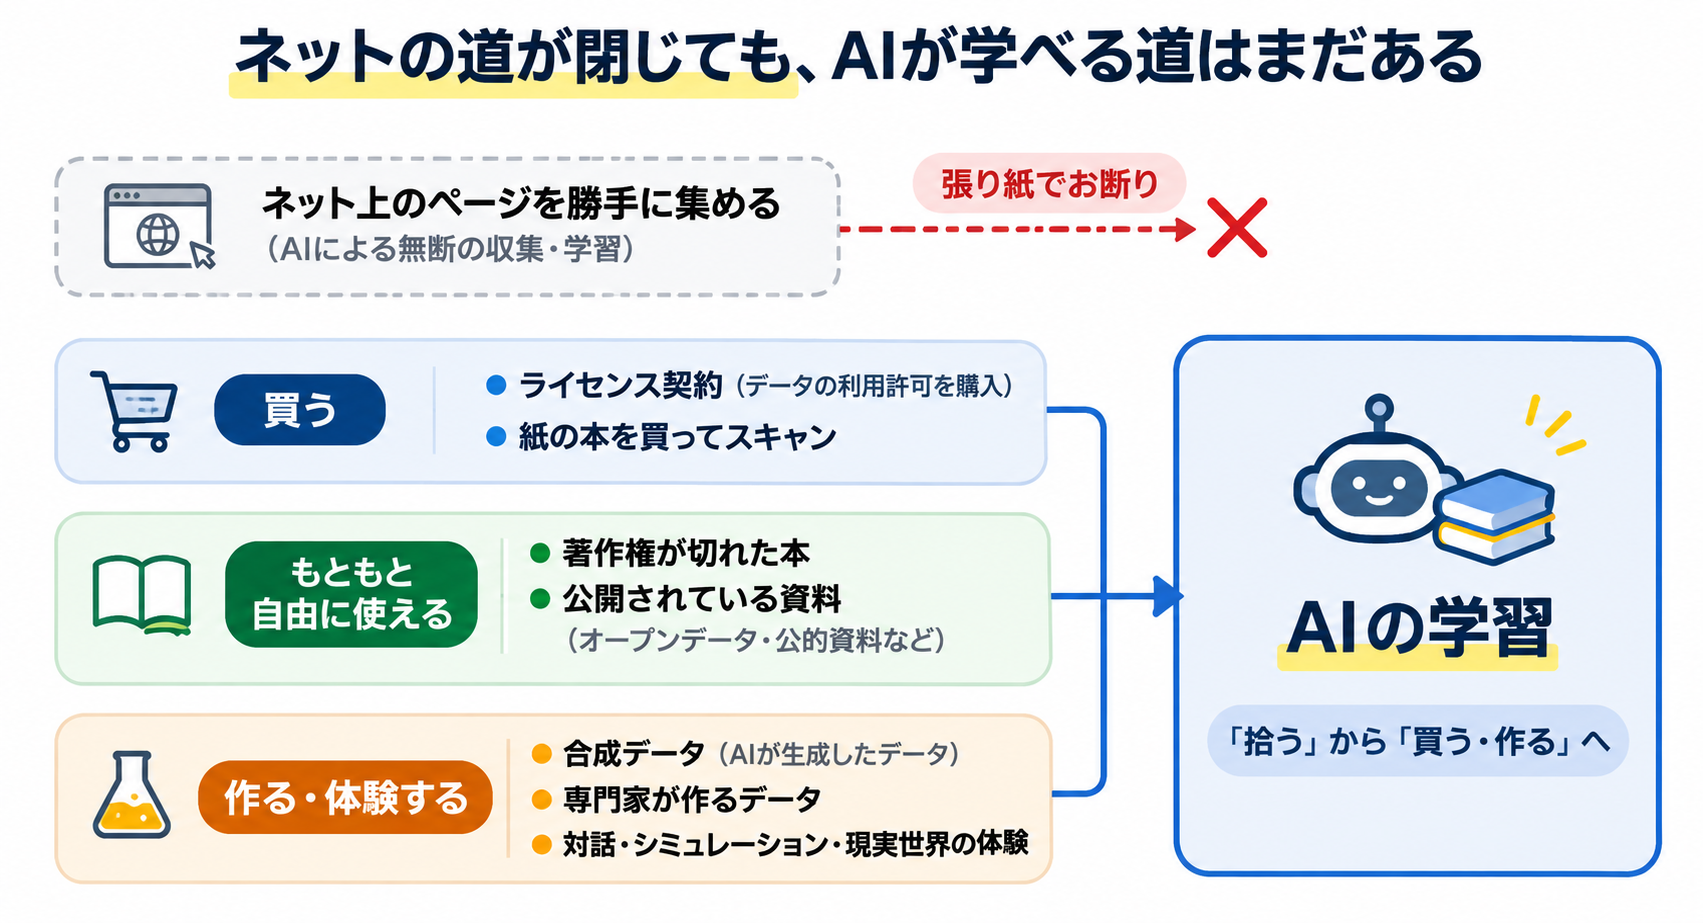
学習ルートの全体像 · ネットから勝手に集める以外の6つのルート
ネットの道が閉じても、AIが学べる道はまだ6つ残っています。大きく分けると「買う」「もともと自由に使える」「作る・体験する」の3グループです。順番に見ていきましょう。
ネットを使わない学び方(その1):買う・使う・スキャンする
1. お金を払ってライセンスを「買う」
張り紙が断っているのは、「勝手に持っていくこと」です。お金を払って許可をもらえば問題ありません。実際、AIの会社は新聞社や出版社などと契約して、データを使わせてもらっています。みんなが断る世界では、この「データの売り買い」がもっと盛んになるはずです。
2. 著作権が切れた本や公開資料など誰でも自由に使えるものを使う
著作権が切れた昔の小説、国が公開している資料、法律や裁判の記録などです。自由に使えますが、量はそれほど多くありません。内容も、古いものやかたい文章にかたよります。これだけでは、今どきの話し言葉は身につきにくいでしょう。
3. 紙の本を買ってスキャンする
本を買って、1ページずつスキャンする方法もあります。これならネットを通りません。実際にAnthropic(Claudeを作っている会社)は、たくさんの本を買ってスキャンしていました。
アメリカの裁判所は2025年6月、「買った本をスキャンしてAIの勉強に使うのはOK」と判断しました。いっぽうで、海賊版の電子書籍を使ったことは問題になり、約15億ドルを支払う和解になりました。
つまり、大事なのは「学んだかどうか」より「どうやって手に入れたか」です。ただし、これはアメリカのひとつの裁判所の判断です。ヨーロッパや日本で同じ答えになるとはかぎりません。
✍ 筆者より
本を1ページずつスキャンする作業めっちゃめんどくさそう・・・
ネットを使わない学び方(その2):作る・体験する
4. AIが作った教材でAIが学ぶ(合成データ)
今あるAIに、問題と答え、会話、プログラムなどを作らせて、それをAIの勉強に使う方法です。これを「合成データ」と呼びます。算数やプログラミングのように、答えが合っているかを機械でチェックできる分野では、とても役に立ちます。
ただし弱点もあります。AIが作ったものだけで何度も勉強をくり返すと、だんだん中身が薄くなっていくのです。コピーのコピーをくり返すと、画質がどんどん荒れていくのと似ています。これを「モデル崩壊」と呼びます。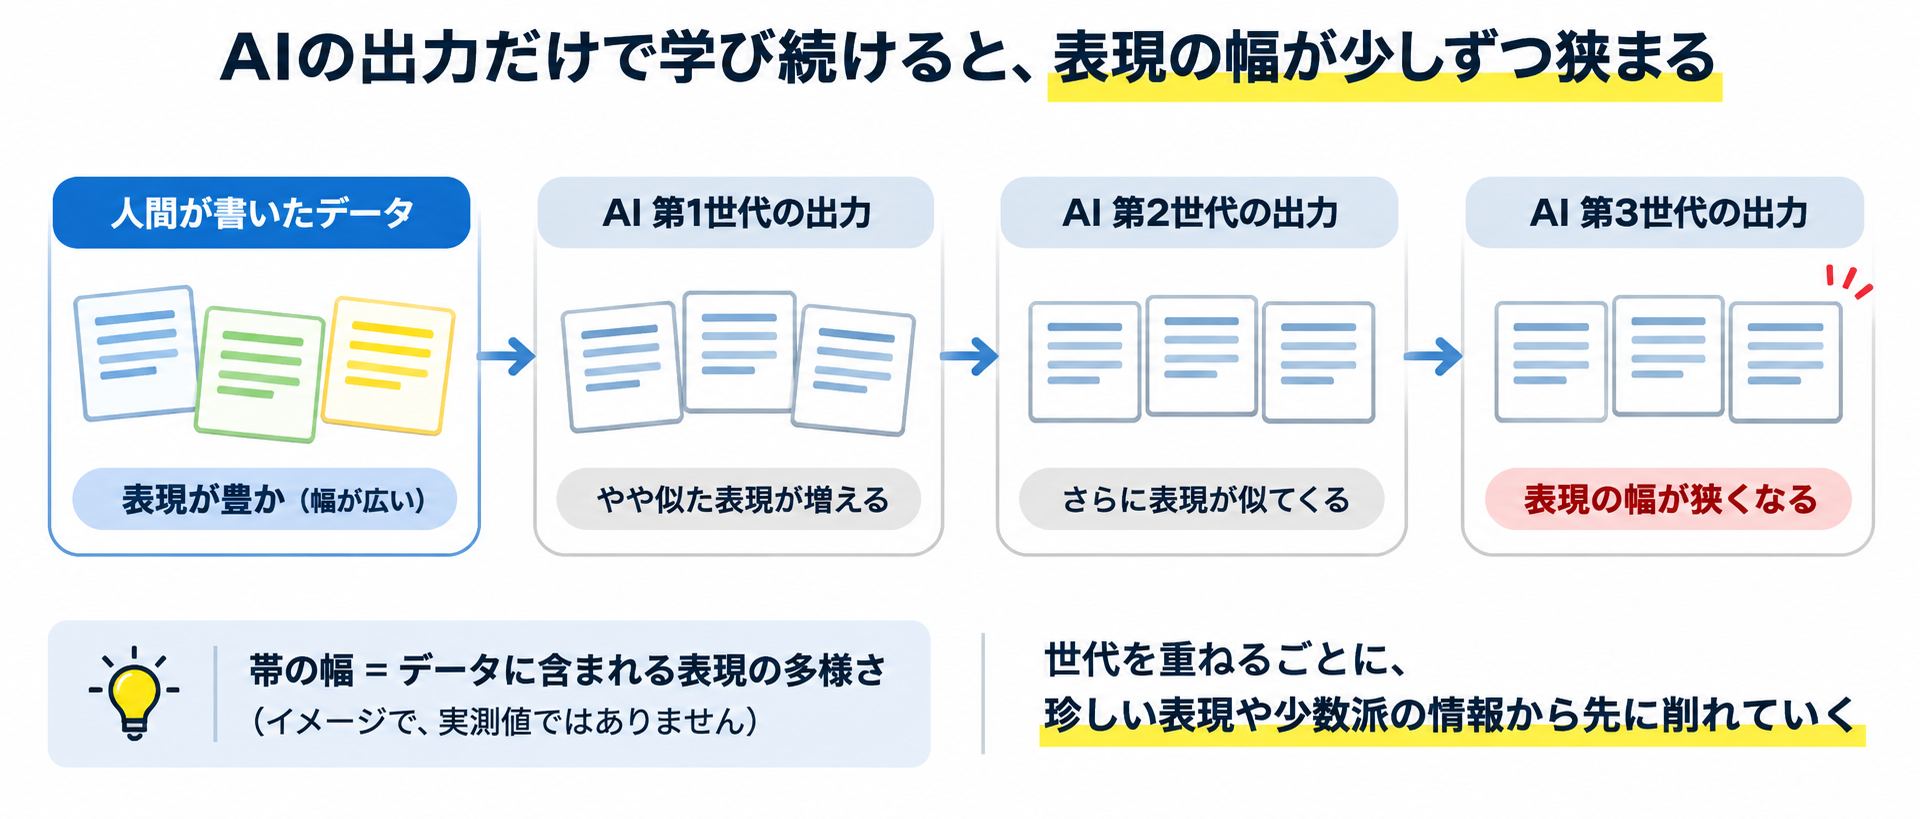
モデル崩壊のイメージ · 世代ごとに多様性が減る
だから、人間が書いた「本物」の文章を混ぜ続けることが欠かせません。人間の文章の価値は、むしろ上がっていきます。
✍ 筆者より
価値が高い文章かどうかはわかりませんが、今回の記事には筆者の文章をところどころにわかるように入れてみました。
5. 人間が先生になって教材を作る
専門家にお願いして、わかりやすい説明やお手本の文章を書いてもらう方法です。AIの答えに点数をつけてもらうこともあります。お金はかかりますが、今のAI作りでは「量より質」が大事になっているので、とても重要な方法です。医者や弁護士、エンジニアが「AIの家庭教師」として働く仕事は、もうあります。
6. 会話や体験から学ぶ
利用者が「使っていいよ」と許可した会話、コンピューターの中の練習場での試行錯誤、ロボットのカメラやセンサーが集めた映像なども、教材になります。子どもが本だけでなく体験からも学ぶように、AIも「読む」以外の学び方を増やしていくでしょう。
そんな世界では何が起きる?
みんなが断る世界でも、AIが弱くなるわけではありません。そのかわり、AIは「データを買えるお金持ちの会社」のものになっていきます。起きそうなことを4つ挙げます。
- お金のある会社が有利になる:データや本をたくさん買える大企業ほど強くなります。大学や小さな会社は、参加しにくくなります。
- 先に集めた人が得をする:みんなが断り始める前にデータを集めていた会社は、そのままリードを保てます。
- 知識がかたよる:個人ブログや小さなコミュニティの知恵、最新の話題、話す人の少ない言葉の情報に、AIが弱くなります。契約できる大手メディアの声ばかりが目立つかもしれません。
- 作った人にお金が届く:逆に、データを提供する記者や作家、専門家にお金が流れる仕組みが育つかもしれません。
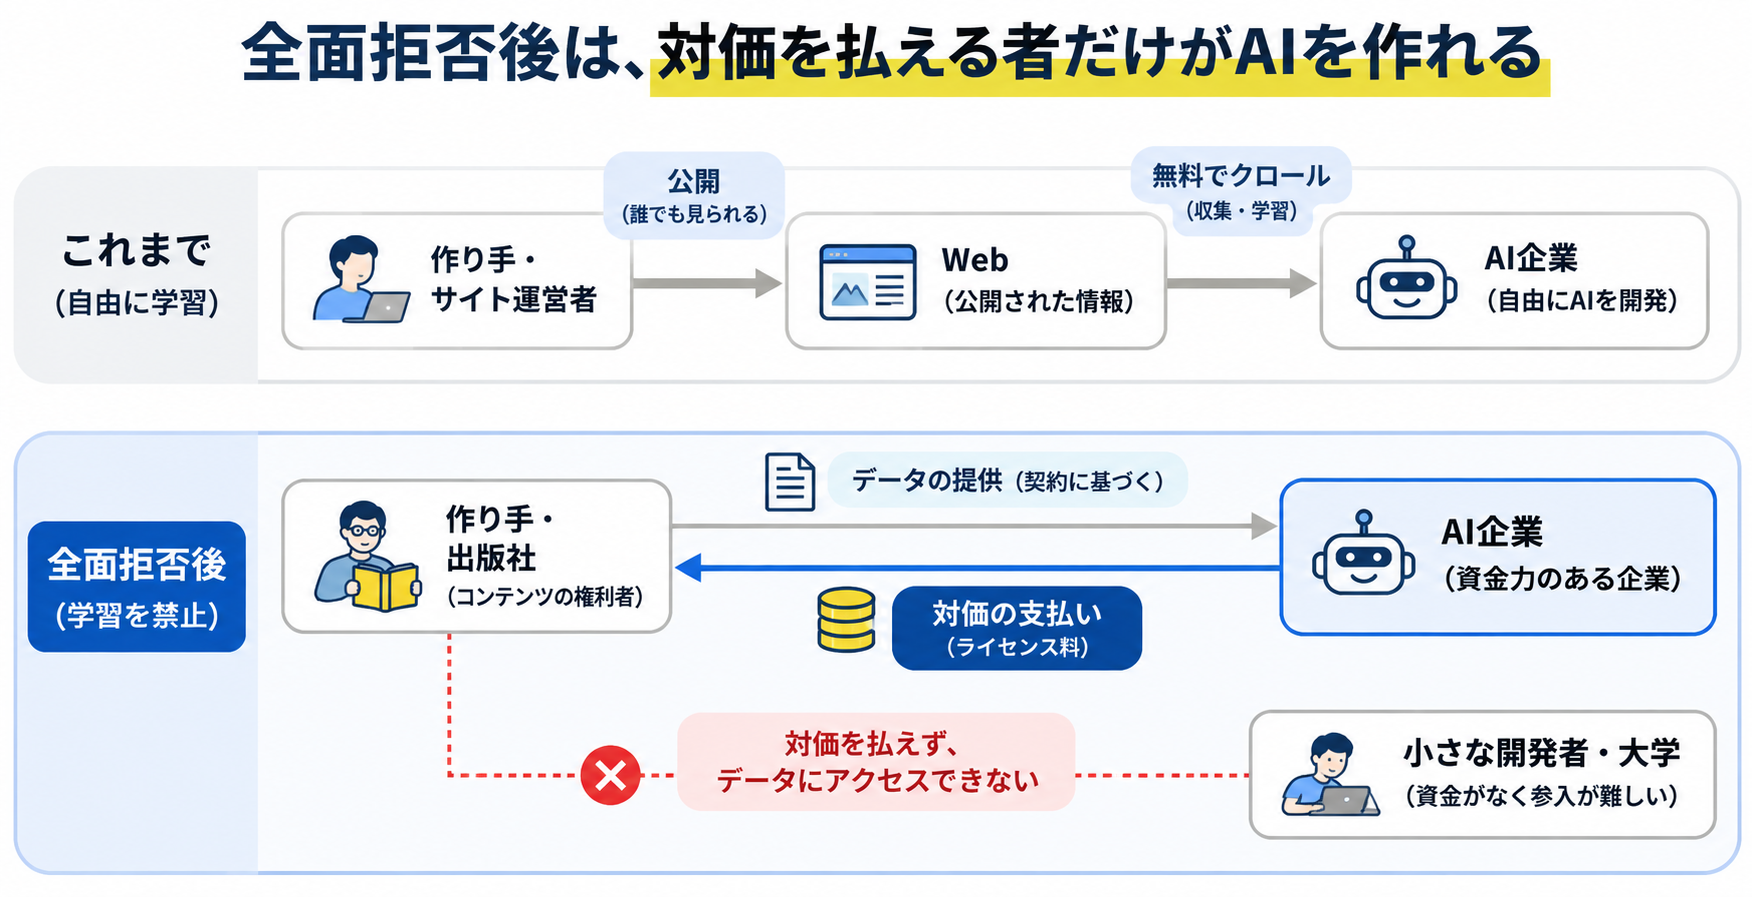
データとお金の流れ · これまでと全面拒否後
これまでは、データが一方的に流れるだけでした。これからは、そのお返しとしてお金も流れるようになります。そのかわり、お金を払えない小さな開発者や大学は、仲間に入れなくなってしまいます。
つまり「みんなで断る」は、AIを止めるスイッチではありません。データの値段と、「誰がAIを作れるか」を変えるスイッチなのです。
✍ 筆者より
データがお金になるならセキュリティーもこれまで以上に重要になってきますね。
わたしたち一般ユーザーにはどう影響する?
この変化は、AIを使うわたしたちにも関係があります。特に身近なのは、「AIの答えの中身」と「料金」です。ここからは、この「もしも」の世界で起きそうなことの予想です。
✍ 筆者より
たとえば私は、仕事以外では主に、Xで見かけたニュースや時事ネタが本当かどうかを確かめるのにAIを使っています。体感だと私のタイムラインに流れてくるニュースの8割が噓な気がします・・・
| 影響 | どうなりそう? | わたしたちにできること |
|---|---|---|
| 答えのかたより | 大手メディアや出版社の情報が中心になり、個人ブログや地元の情報、少数派の意見が減る | 大事なことはAIだけで決めず、ほかの情報も見る |
| 情報の新しさ | 最新の話題や、くわしい人しか知らない話に弱くなる | 答えの出典と日付をチェックする |
| 料金 | データを買うお金が料金に上乗せされ、無料で使える範囲がせまくなるかもしれない | 自分の使い方に合うプランやサービスを比べて選ぶ |
| 選べるサービス | データを買える一部の会社にサービスが集まる | 1つの会社だけに頼りすぎない |
| 自分の会話 | ネットから集められない分、利用者との会話が大事な教材になる | AIサービスの「学習に使う」設定を確かめて、自分で選ぶ |
| 発信する側として | 自分のブログや投稿は守られるが、個人は契約の交渉ができず、お金は受け取りにくい | どこに公開するかと、その場所の利用規約を意識する |
みんなが自分のサイトを守るほど、AIの中の「ふつうの人の声」は小さくなっていきます。作る人を守るための行動が、使う人にとっては「便利だけど、かたよっていて、少し高いAI」を生むかもしれません。
AIの信頼と価値はどう変わる?
「偏ったAI」になるなら、AIを信じる人は減りそうですよね。ただ、AIの価値が丸ごと下がるわけではありません。「得意なこと」と「苦手なこと」が、はっきり分かれていくだけです。
たとえるなら「物知りな友だち」
AIを、何でも教えてくれる物知りな友だちだと思ってください。その友だちが、ある日から新聞もネットも読めなくなったとします。
最近のニュースを聞いても、答えは古いかもしれません。だからそのうち、ニュースのことは聞かなくなります。でも、手紙の書き方を相談したり、計算を手伝ってもらったりするのは、今までどおり頼れますよね。AIに起きることも、ちょうどこれと同じです。
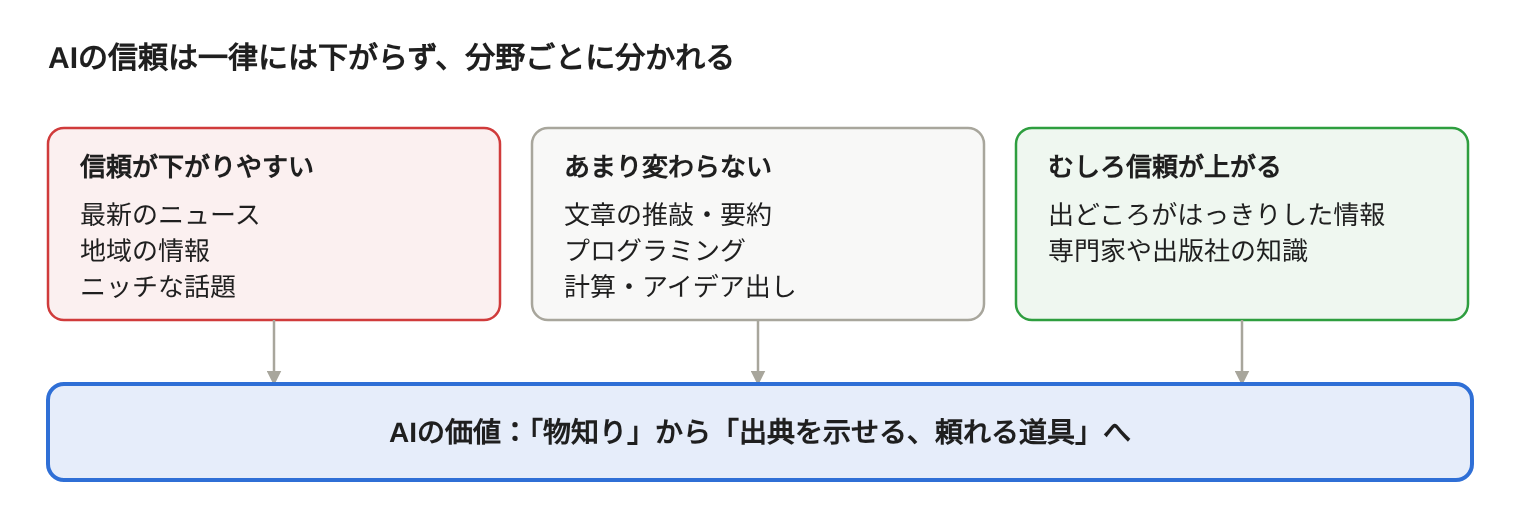
AIの信頼と価値の変化 · 分野ごとに明暗が分かれる
信頼が下がりやすいのは「新しいこと」「身近なこと」
最新のニュース、近所のお店の情報、趣味の細かい話題などです。こうした情報は、個人のブログや小さなサイトに多く載っていました。そこから学べなくなると、AIの答えは古くなったり、ずれたりしやすくなります。
✍ 筆者より
私のように、ニュースや時事ネタの事実確認にAIを使っている人は、まさにこの影響を受けそうです。
あまり変わらないのは「考える・書く」仕事
文章を直す、長い資料をまとめる、プログラムを書く、アイデアを出す。こうした仕事に必要なのは、最新の知識より「考える力」と「言葉を扱う力」です。だから、ここでのAIの便利さはほとんど変わりません。
むしろ信頼が上がる面もある
お金を払って手に入れたデータは、出版社や専門家など「出どころ」がはっきりしています。ネットの情報をまるごと学んだAIより、「この本やこの新聞から学んだ」と説明できるAIのほうが、安心して使えるという人もいるはずです。
「覚える」と「その場で調べる」は別の話
実は今も、多くのサイトは「学習に使うのはダメ」でも、「検索で表示するのはいい」としています。図書館の本を丸ごと暗記するのはダメでも、必要なときに調べて「この本にこう書いてあります」と教えるのはOK、というイメージです。
AIが質問のたびに検索して、出典を示しながら答えるようになれば、知識の古さはかなり補えます。ただし、検索まで拒否される世界になれば、この道もふさがれます。
結局どうなる?
AIは「何でも知っている物知り」から、「一緒に考えたり作業したりする道具」に変わっていきそうです。信頼できるかどうかの目安も、「たくさん知っているか」から「どこから持ってきた情報かを示せるか」に変わるでしょう。
使う側のコツはシンプルです。考える・書く仕事はどんどん任せる。新しい情報や大事な事実は、出典を自分の目で確かめる。この2つを使い分けるだけで、AIとはずっと付き合いやすくなります。
日本の企業が気を付けたいこと
こんな未来が想像できる今、企業は「AIを使う側」と「データを持っている側」の両方から備えておく必要があります。ポイントは大きく3つです。
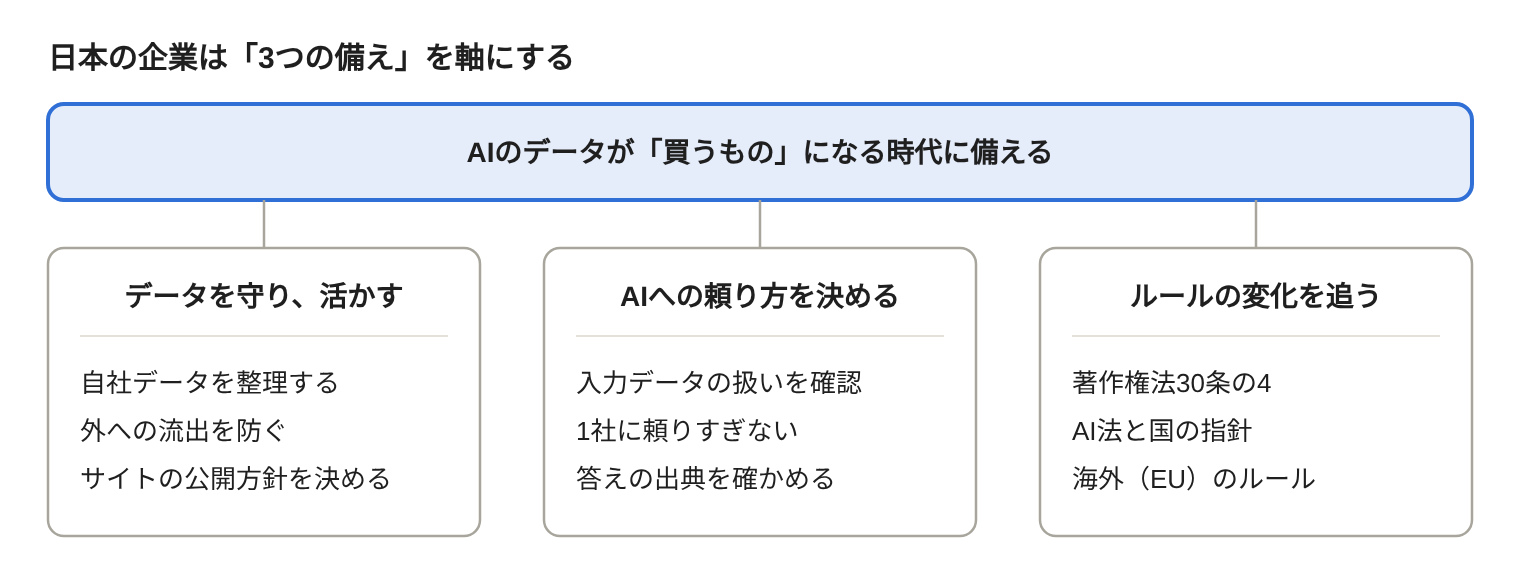
日本の企業の3つの備え
1. 自社のデータを「宝物」として扱う
社内の資料、仕事のノウハウ、お客さんとのやり取りの記録。こうしたデータは、「質のいいデータが貴重になる世界」では宝物になります。特に、質の高い日本語のデータはもともと多くありません。
だから、まずはどんなデータがあるのかを整理しておきましょう。そうすれば、将来「使わせてあげる」ことも、「知らないうちに持ち出されないよう守る」こともできます。
2. 張り紙は「全部お断り」にしない
張り紙(robots.txt)では、「勉強用のロボット」と「検索用のロボット」を別々に扱えます。全部断ってしまうと、AIに質問した人に自分の会社を見つけてもらえなくなるかもしれません。「守りたいページ」と「見てほしいページ」を分けて考えるのがおすすめです。
3. AIサービスの約束ごとを確かめる
社員がAIに入力した内容が、AIの勉強に使われていないか。これは最低限チェックしておきたいところです。会社向けプランの条件や、データの扱いの約束ごとも見ておきましょう。
また、AIの答えはかたよることがあります。大事な判断では「出典を確かめる」ことを、社内の当たり前にしておくと安心です。
4. 1つのAIに頼りすぎない
データを買える会社が少なくなれば、AIサービスの値上げや、一部の会社への集中が起きやすくなります。大事な仕事をひとつのサービスにだけ任せず、いざというときに乗り換えられるようにしておきましょう。
5. 日本と海外のルールの違いを知っておく
日本は、AIの勉強に対して比較的ゆるやかな国です。著作権法の30条の4というルールで、作品の売れ行きに大きな影響を与えない使い方なら、柔軟に認める考え方をとっています。ただし「作った人の利益を不当に害する」場合は例外で、音楽業界などからは見直しを求める声もあります。
2025年にできたAI法には、企業への罰則はありません。それでも、国の指針や「AI事業者ガイドライン」が、実際の仕事での「守るべき目安」になっています。2026年7月に決まった国の計画でも、ルールをこれからも見直し続けるとされています。今のルールは「完成版」ではなく「途中経過」だと考えておきましょう。
海外、特にヨーロッパで仕事をするなら、「張り紙を守ること」がルールになっている点にも注意が必要です。
ひとことで言うと
「自分たちのデータの価値を知って守る」「AIへの頼り方を自分で決める」「ルールの変化を追いかける」。この3つを意識しておけば、どんな未来になってもあわてずにすみます。
まとめ:「タダで拾う」から「買う・作る」へ
すべてのサイトがAIの勉強を断っても、AIは学び続けます。データを買ったり、本をスキャンしたり、AIや専門家が教材を作ったり、体験から学んだりするからです。変わるのは、データが「タダで拾えるもの」から「お金を払って手に入れるもの」になることです。
そしてこの変化は、もう始まっています。これから大切になるのは、「AIは何から学ぶのか」より、「そのお金は誰に届き、誰の声がAIの中に残るのか」なのかもしれません。
✍ 筆者より
私自身は、「こうあるべきだ」というはっきりした考えがあるわけではありません。それでも、わたしたち一般ユーザーにとって使いやすく、情報がかたよらない公平な環境になってほしいと思います。
参考
- Final AI Code of Practice published by European Commission(NEMO)
- Stakeholder consultation on AI and copyright compliance(欧州委員会)
- Destructive scanning and the ‘fair use’ doctrine(Law Society Gazette)
- Anthropic’s $1.5B Settlement: What Fair Use Now Costs(Digital Applied)
- State of Web Access 2026: AI agents(Zyte)
- AIと著作権について(文化庁)
- 「AIと著作権に関する考え方について(素案)」に関する意見(日本レコード協会)
- 日本のAI法制――AI法とソフトローの二層構造(One Asia Lawyers)
- AI法 全面施行(内閣府)

Webマーケター/広告運用担当。ゲームが好きです。